资料摄取 Ingest|来源、流程与 Wiki 产出
了解支持的来源、处理管线、人工确认与可追溯的知识产出。
- 开发预览
- 本页模块仍在开发预览中,实际入口以当前版本为准。
摄取(ingest)把一份原始资料处理成能够阅读、检索、核对和复用的知识。它保留来源,再提出主题,由你确认后生成 Wiki。保存文件、准备好主题和写完知识笔记,是三个不同结果。
可以添加哪些来源
在知识库的“资料”页点击“添加资料”,选择文档或网页。当前原生入口支持以下输入。
- 输入 · 当前入口 · 使用前检查
- PDF、EPUB、DOCX · 文档 · 检查正文能否读取。扫描页可能需要文字识别。
- Markdown(.md、.markdown)、TXT · 文档 · 先用结构清楚的短文验证流程。
- CSV · 文档 · 可进入文档处理,不等于已完成表格统计或数据分析。
- http / https 网页 · 网页 · 保存正文和原始链接。需要登录的页面可能无法获取。
本地文件必须非空,大小不超过 128 MB。当前文件选择器不接受本地 HTML、PPTX、XLSX、独立图片、音频或视频。聊天可上传某种附件,不表示原生摄取也支持该格式。
请使用不含用户名或密码的网页地址。动态内容、登录和付费内容的提取质量需要单独检查。成功保存一个网页,不代表所有页面元素都已进入正文。
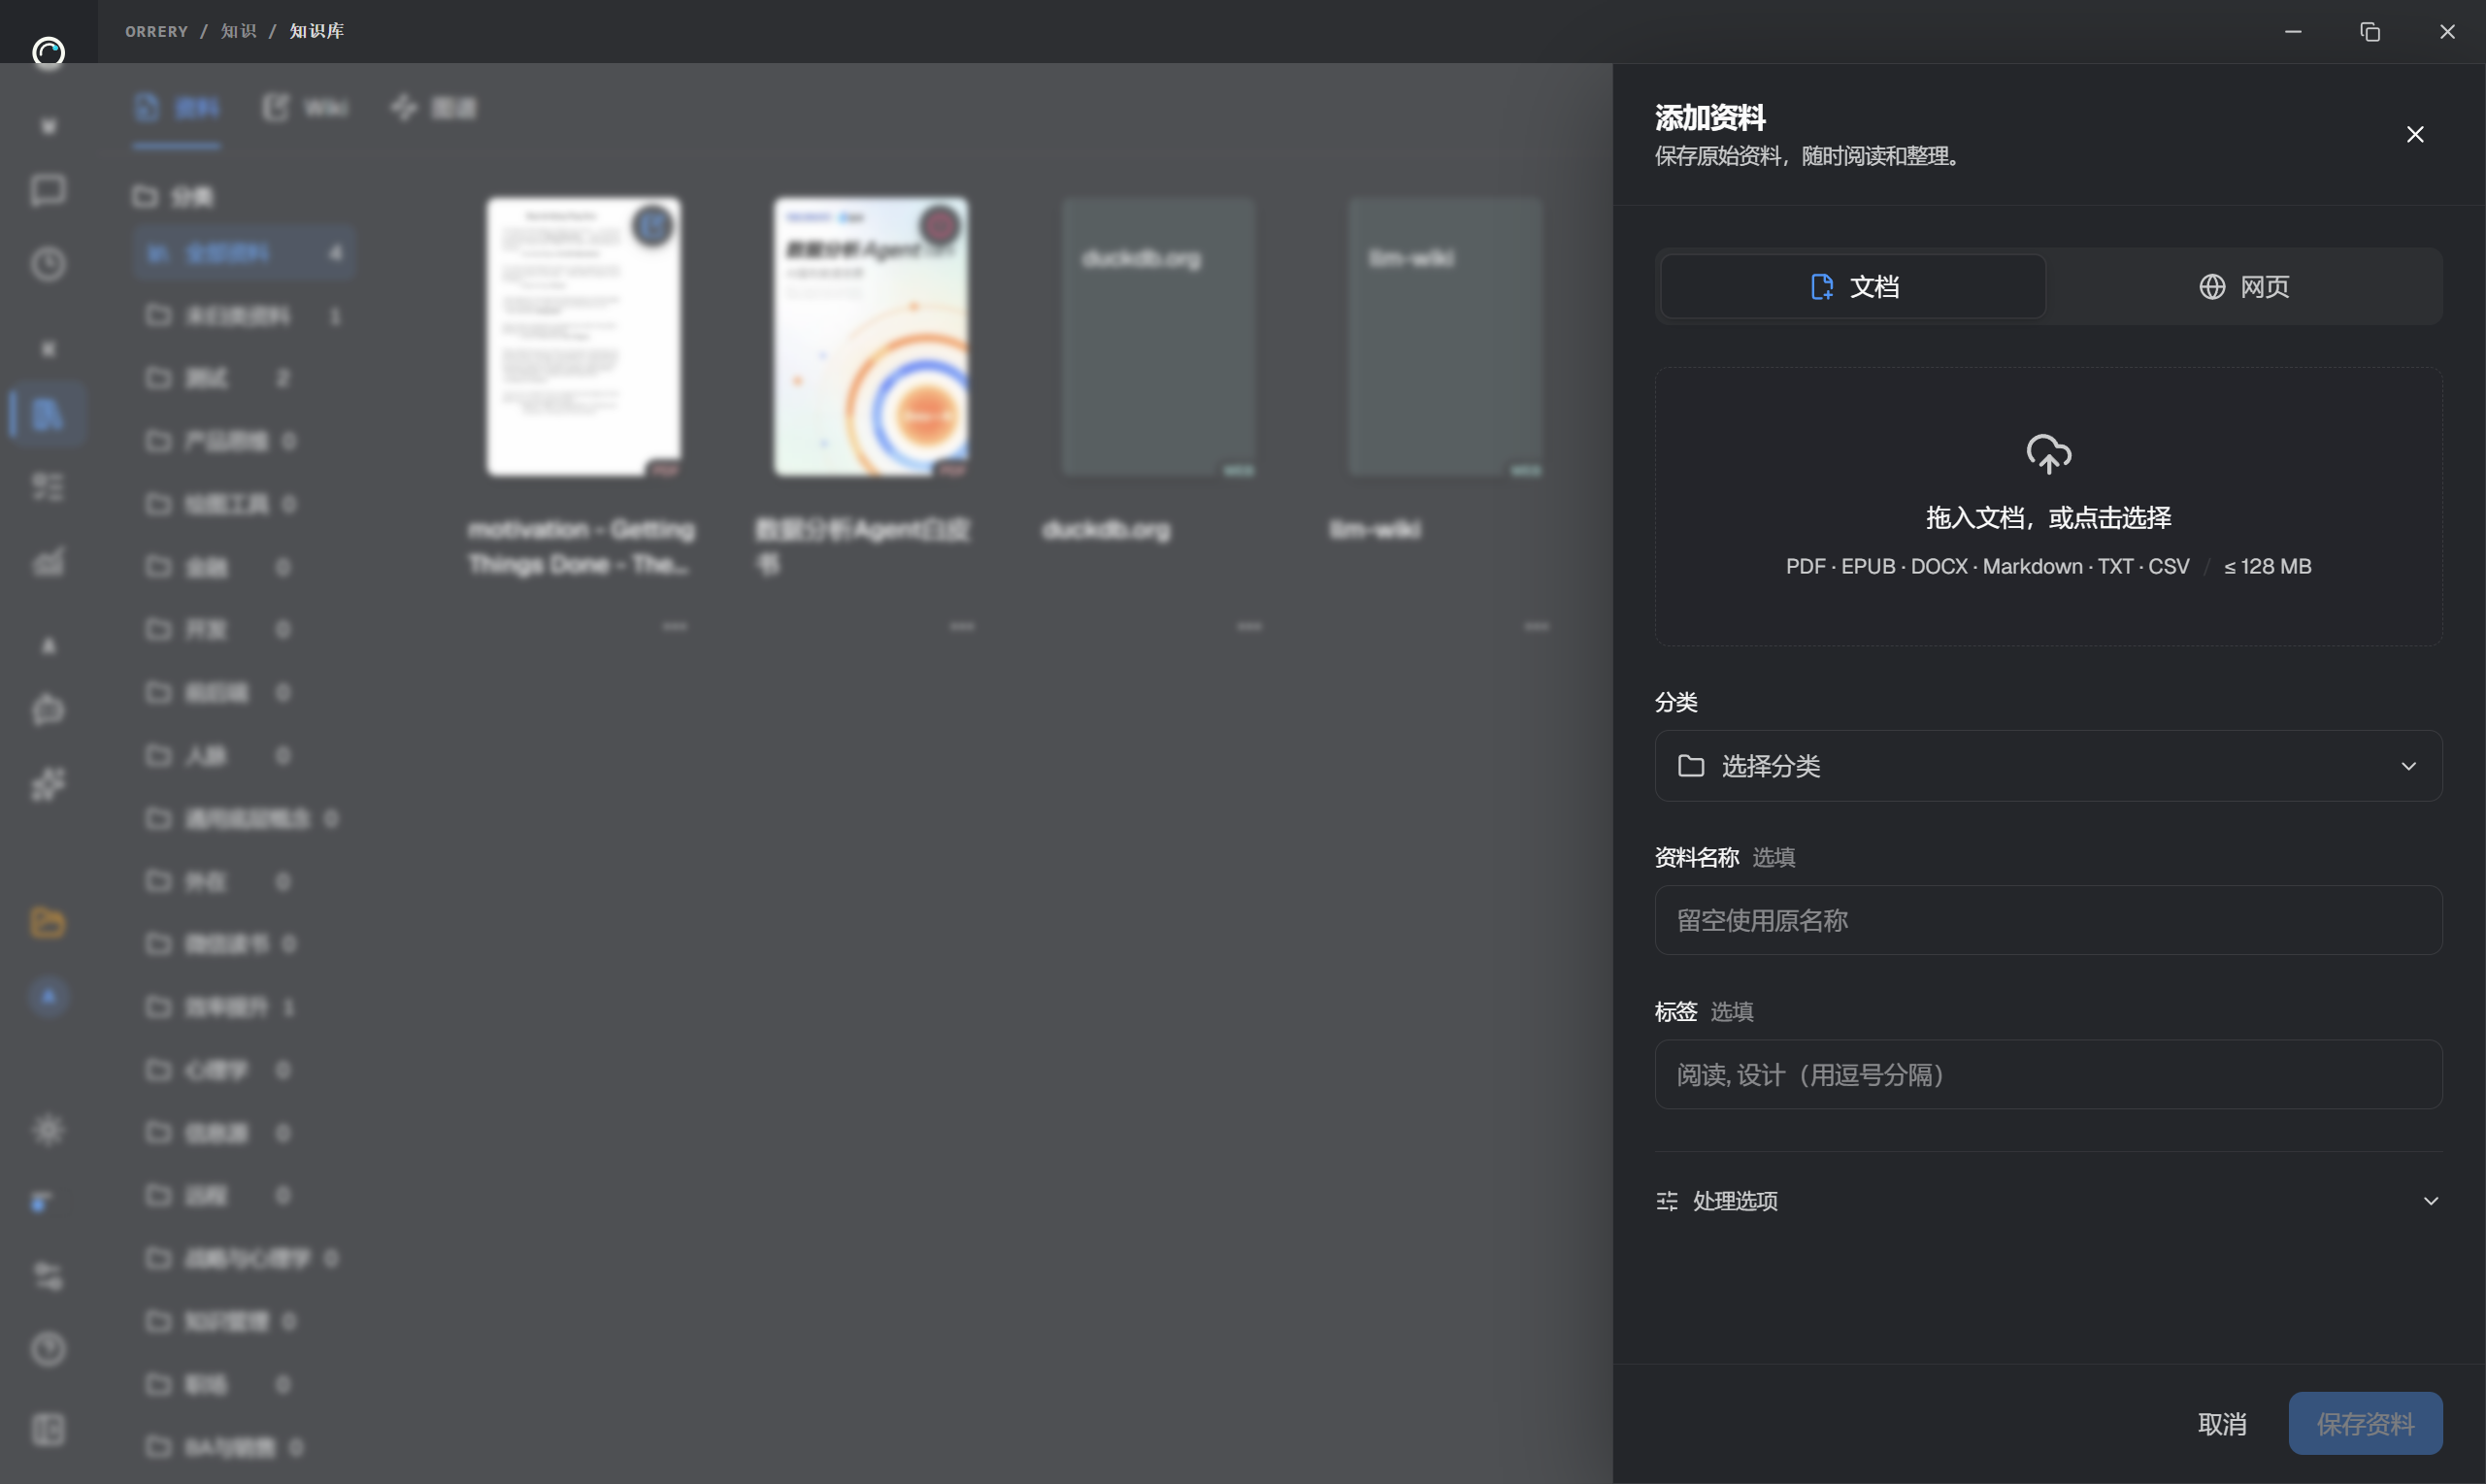
真实“添加资料”面板列出支持格式、128 MB 限制和保存分类。本次未提交。
Pipeline 怎样运行
Pipeline 是按阶段执行的处理管线。界面主流程分为七步,Wiki 整理中还有主题分析与人工确认。
- 读取已保存来源:读取原件,并记录来源内容指纹。
- 解析完整文档:提取正文,保留可获得的章节、页码和图片信息。
- 图片与扫描页识别:按选项分析图片,或为缺少可靠正文的扫描页识别文字。
- 分块与全文快照:保存处理全文,按模型输入预算分块,并保留出处。
- 关键词索引:为来源正文建立关键词检索索引。这一步不使用 embedding。
- 整理知识与 Wiki:提取主题、关联原文、统一主题身份、安排写作归属,再给出收藏建议和理解顺序。等待你确认后,才综合摘要、撰写主题笔记并建立链接。
- 保存处理结果:记录实际文件路径和本次处理历史。
- 从资料到 Wiki 的审核路线
- 保存来源
保留原始文档或网页和出处。
- 解析与识别
提取正文,按选项识别图片或扫描页。
- 全文与索引
保存全文快照、分块和关键词索引。
- 提出候选主题
关联原文依据,核对主题身份与写作归属。
- 人工确认
可以修改、保存选择或稍后继续;确认前不生成最终主题正文。
- 生成知识与回链
综合摘要、主题笔记、来源回链、关联笔记与 Wiki MOC。
- 核对实际产出
打开真实文件,检查来源和处理历史。
等待确认时显示 awaiting_review。这表示流程停在人工选择处,最终主题正文尚未生成。AI 的结构、身份和证据检查帮助发现问题,仍需要人阅读原文。
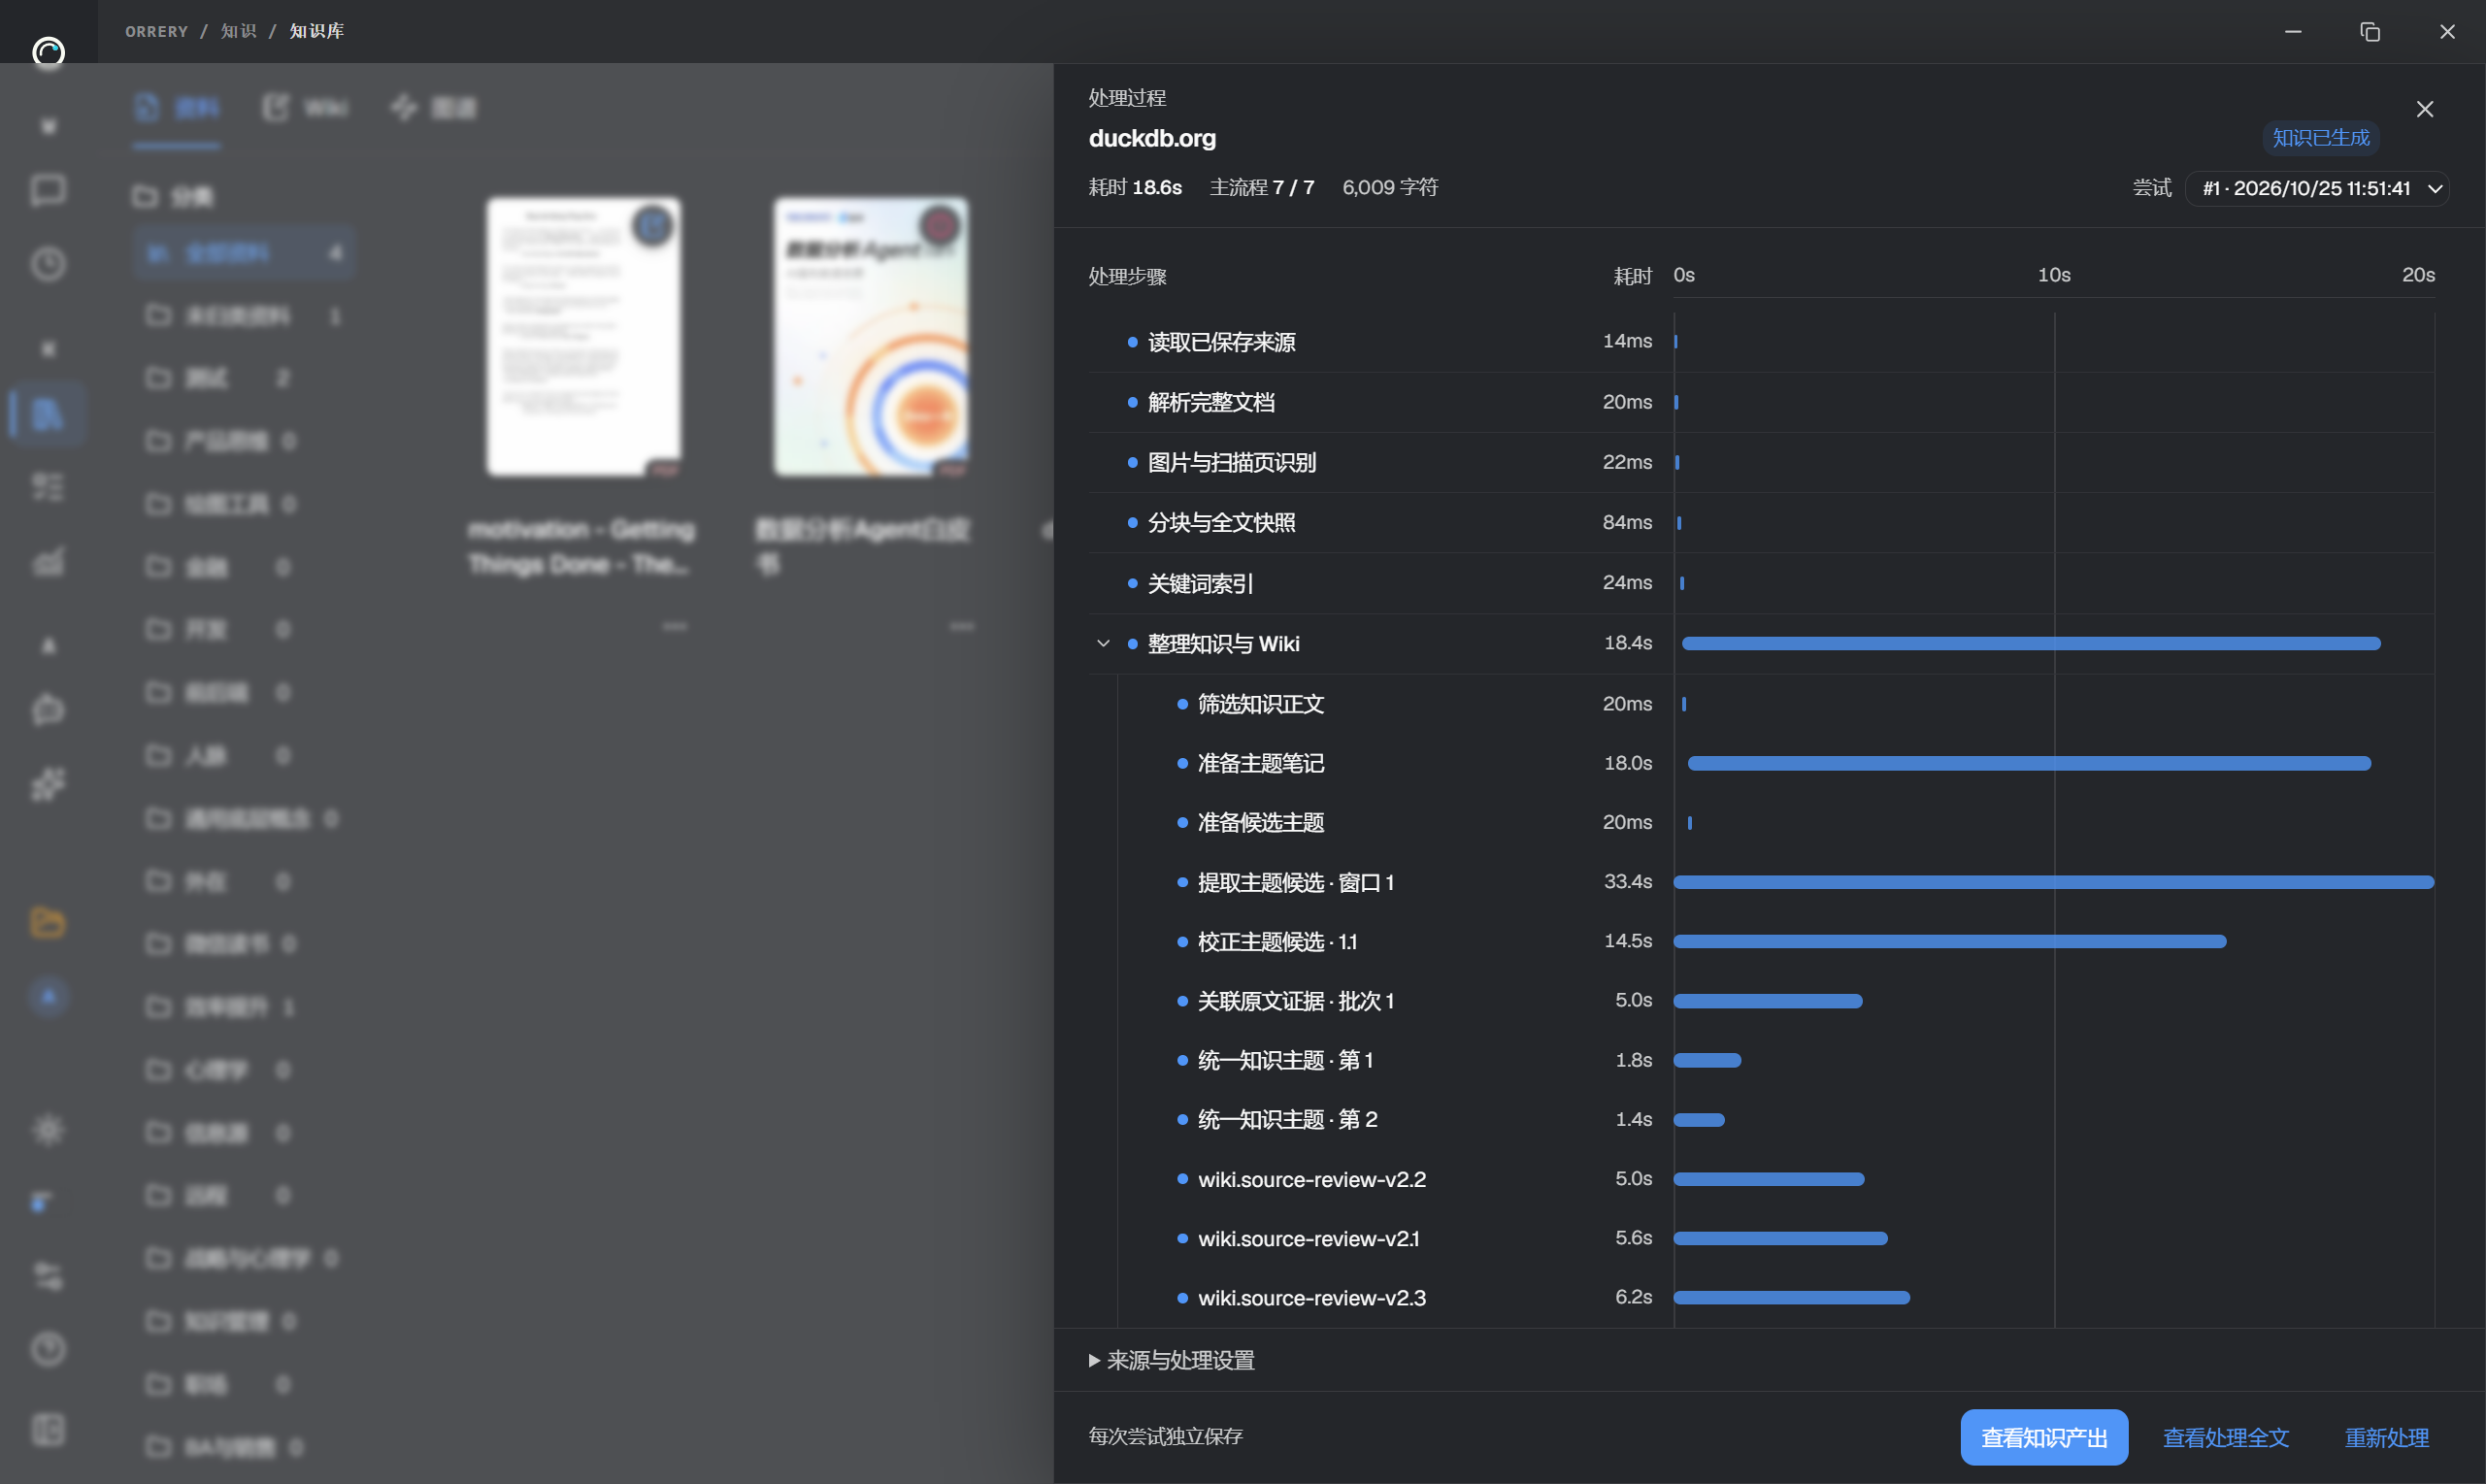
已有 DuckDB 处理记录显示七个主阶段及 Wiki 内部步骤;这张完成记录不是本轮新运行的验收。
PDF 的目录、索引页可能按当前规则排除在 Wiki 主题分析之外。完整来源正文和关键词索引仍保留。不要把这种规则理解为所有书籍版式都能准确识别。
完成后会留下什么
来源与知识分开保存。下面是本地 PDF 导入后的示意结构,具体名称、知识域和 Wiki 根目录取决于配置及审核结果。
<Vault>/
├─ 3. Resources/<保存分类>/<资料名>/
│  ├─ <原文件名>.pdf             原件
│  ├─ <资料名>.md                解析后的可读正文
│  ├─ assets/                    提取的资源(如有)
│  └─ .source.json               应用维护的来源标记
├─ wiki/                         由知识目录配置决定
│  ├─ <知识域>/
│  │  ├─ <主题标题>.md           综合主题笔记
│  │  └─ moc.md                  知识域导航
│  ├─ _sources/<来源标题>.md      来源摘要与回链
│  └─ moc.md                     Wiki 总导航
└─ .orrery/ingest-runs/<runId>/   全文、分块、检查点与产出记录
新导入的 Markdown 原件放在资料文件夹的 original/ 中,避免与解析正文同名。旧资料不会因为这套流程自动搬家。网页保存的是提取正文及来源链接,不应称为完整网站镜像。
一份资料可以生成多篇主题笔记。同一身份也可能与已有 Wiki 页面衔接。写作会区分独立页面、页面内章节和来源元信息,原始候选数量不一定等于新增文件数。产出列表还包含摘要和导航,不能把列表项总数当作知识笔记篇数。
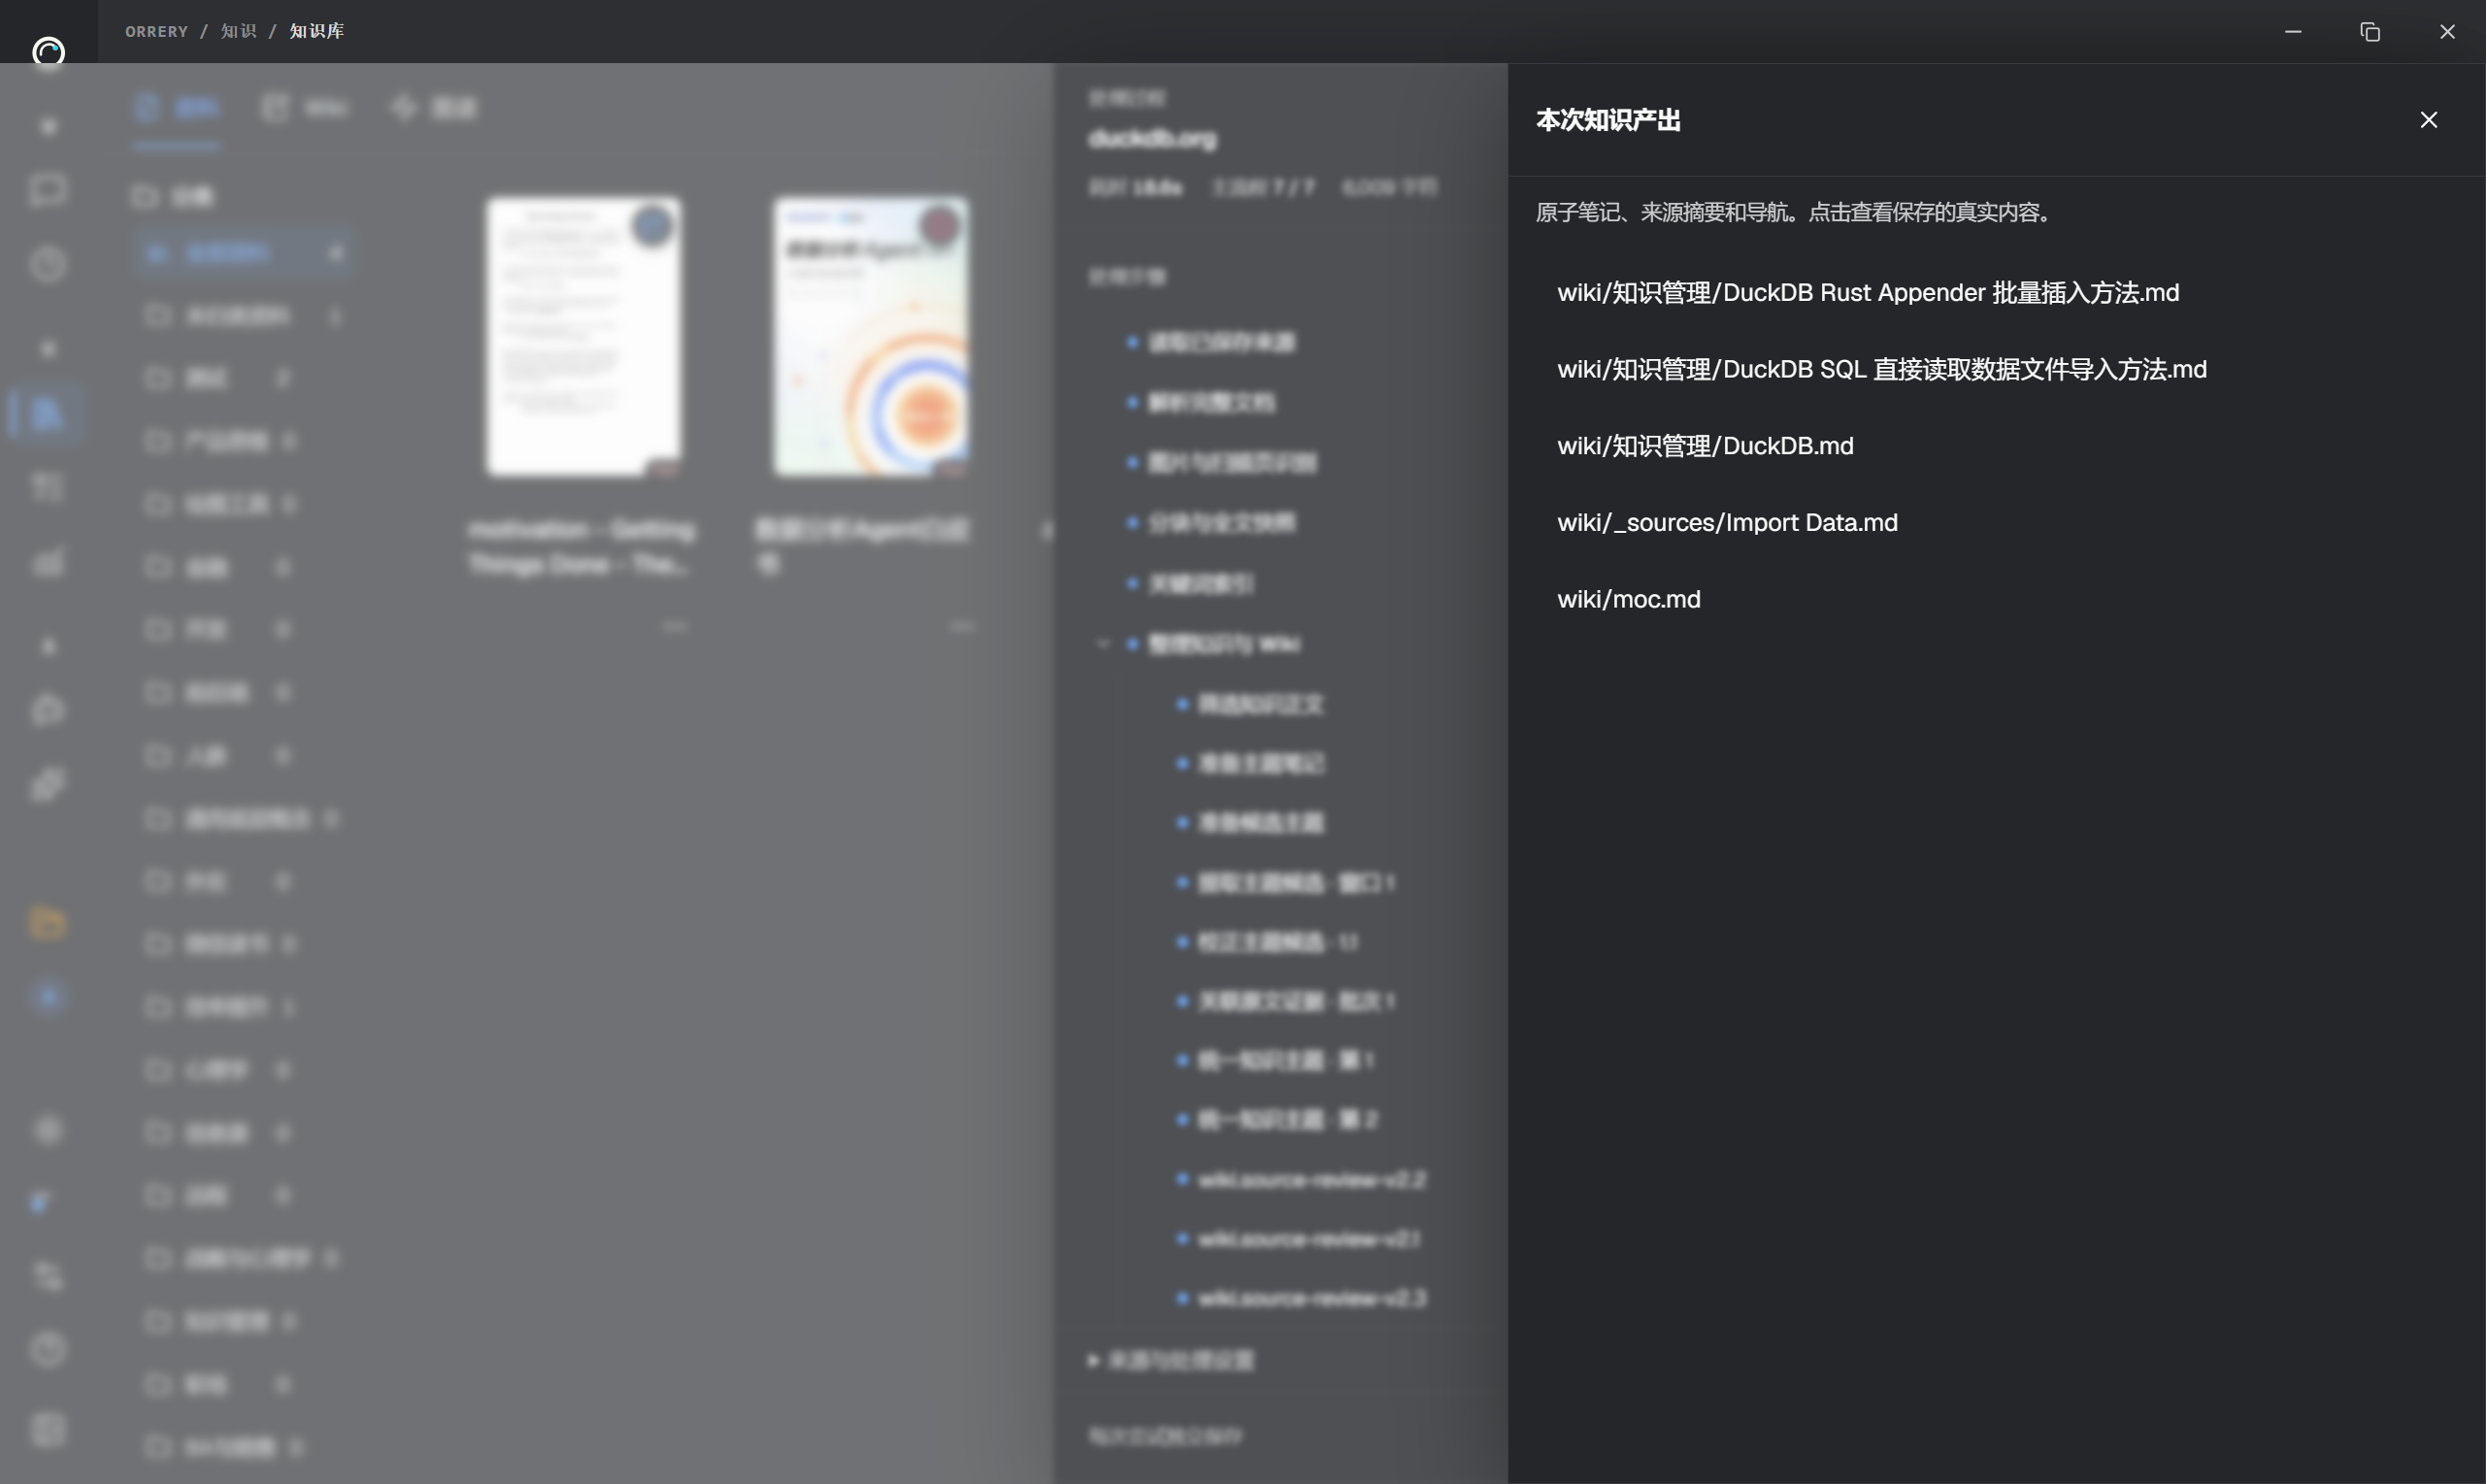
这次历史任务列出三篇主题笔记、一篇来源摘要和 Wiki 总 MOC。知识域 MOC 也由管线维护,但不一定单列在产出列表中。
生成完成只表示文件已写出。生成笔记的人工核对标记仍可能是 reviewed: false,需要继续检查正文。
资料与 Wiki 怎样联系
资料负责保留原始证据。Wiki 负责组织概念、对象和方法。来源摘要提供整份资料的入口,主题笔记保留来源回链及可获得的页码、章节、段落或分块位置。
从资料预览的“关联知识”可以查看对应笔记,再进入 Wiki 阅读。反过来,检查知识笔记中的来源,回到原文核对具体论断。存在回链只说明可以追溯,不直接证明内容正确。
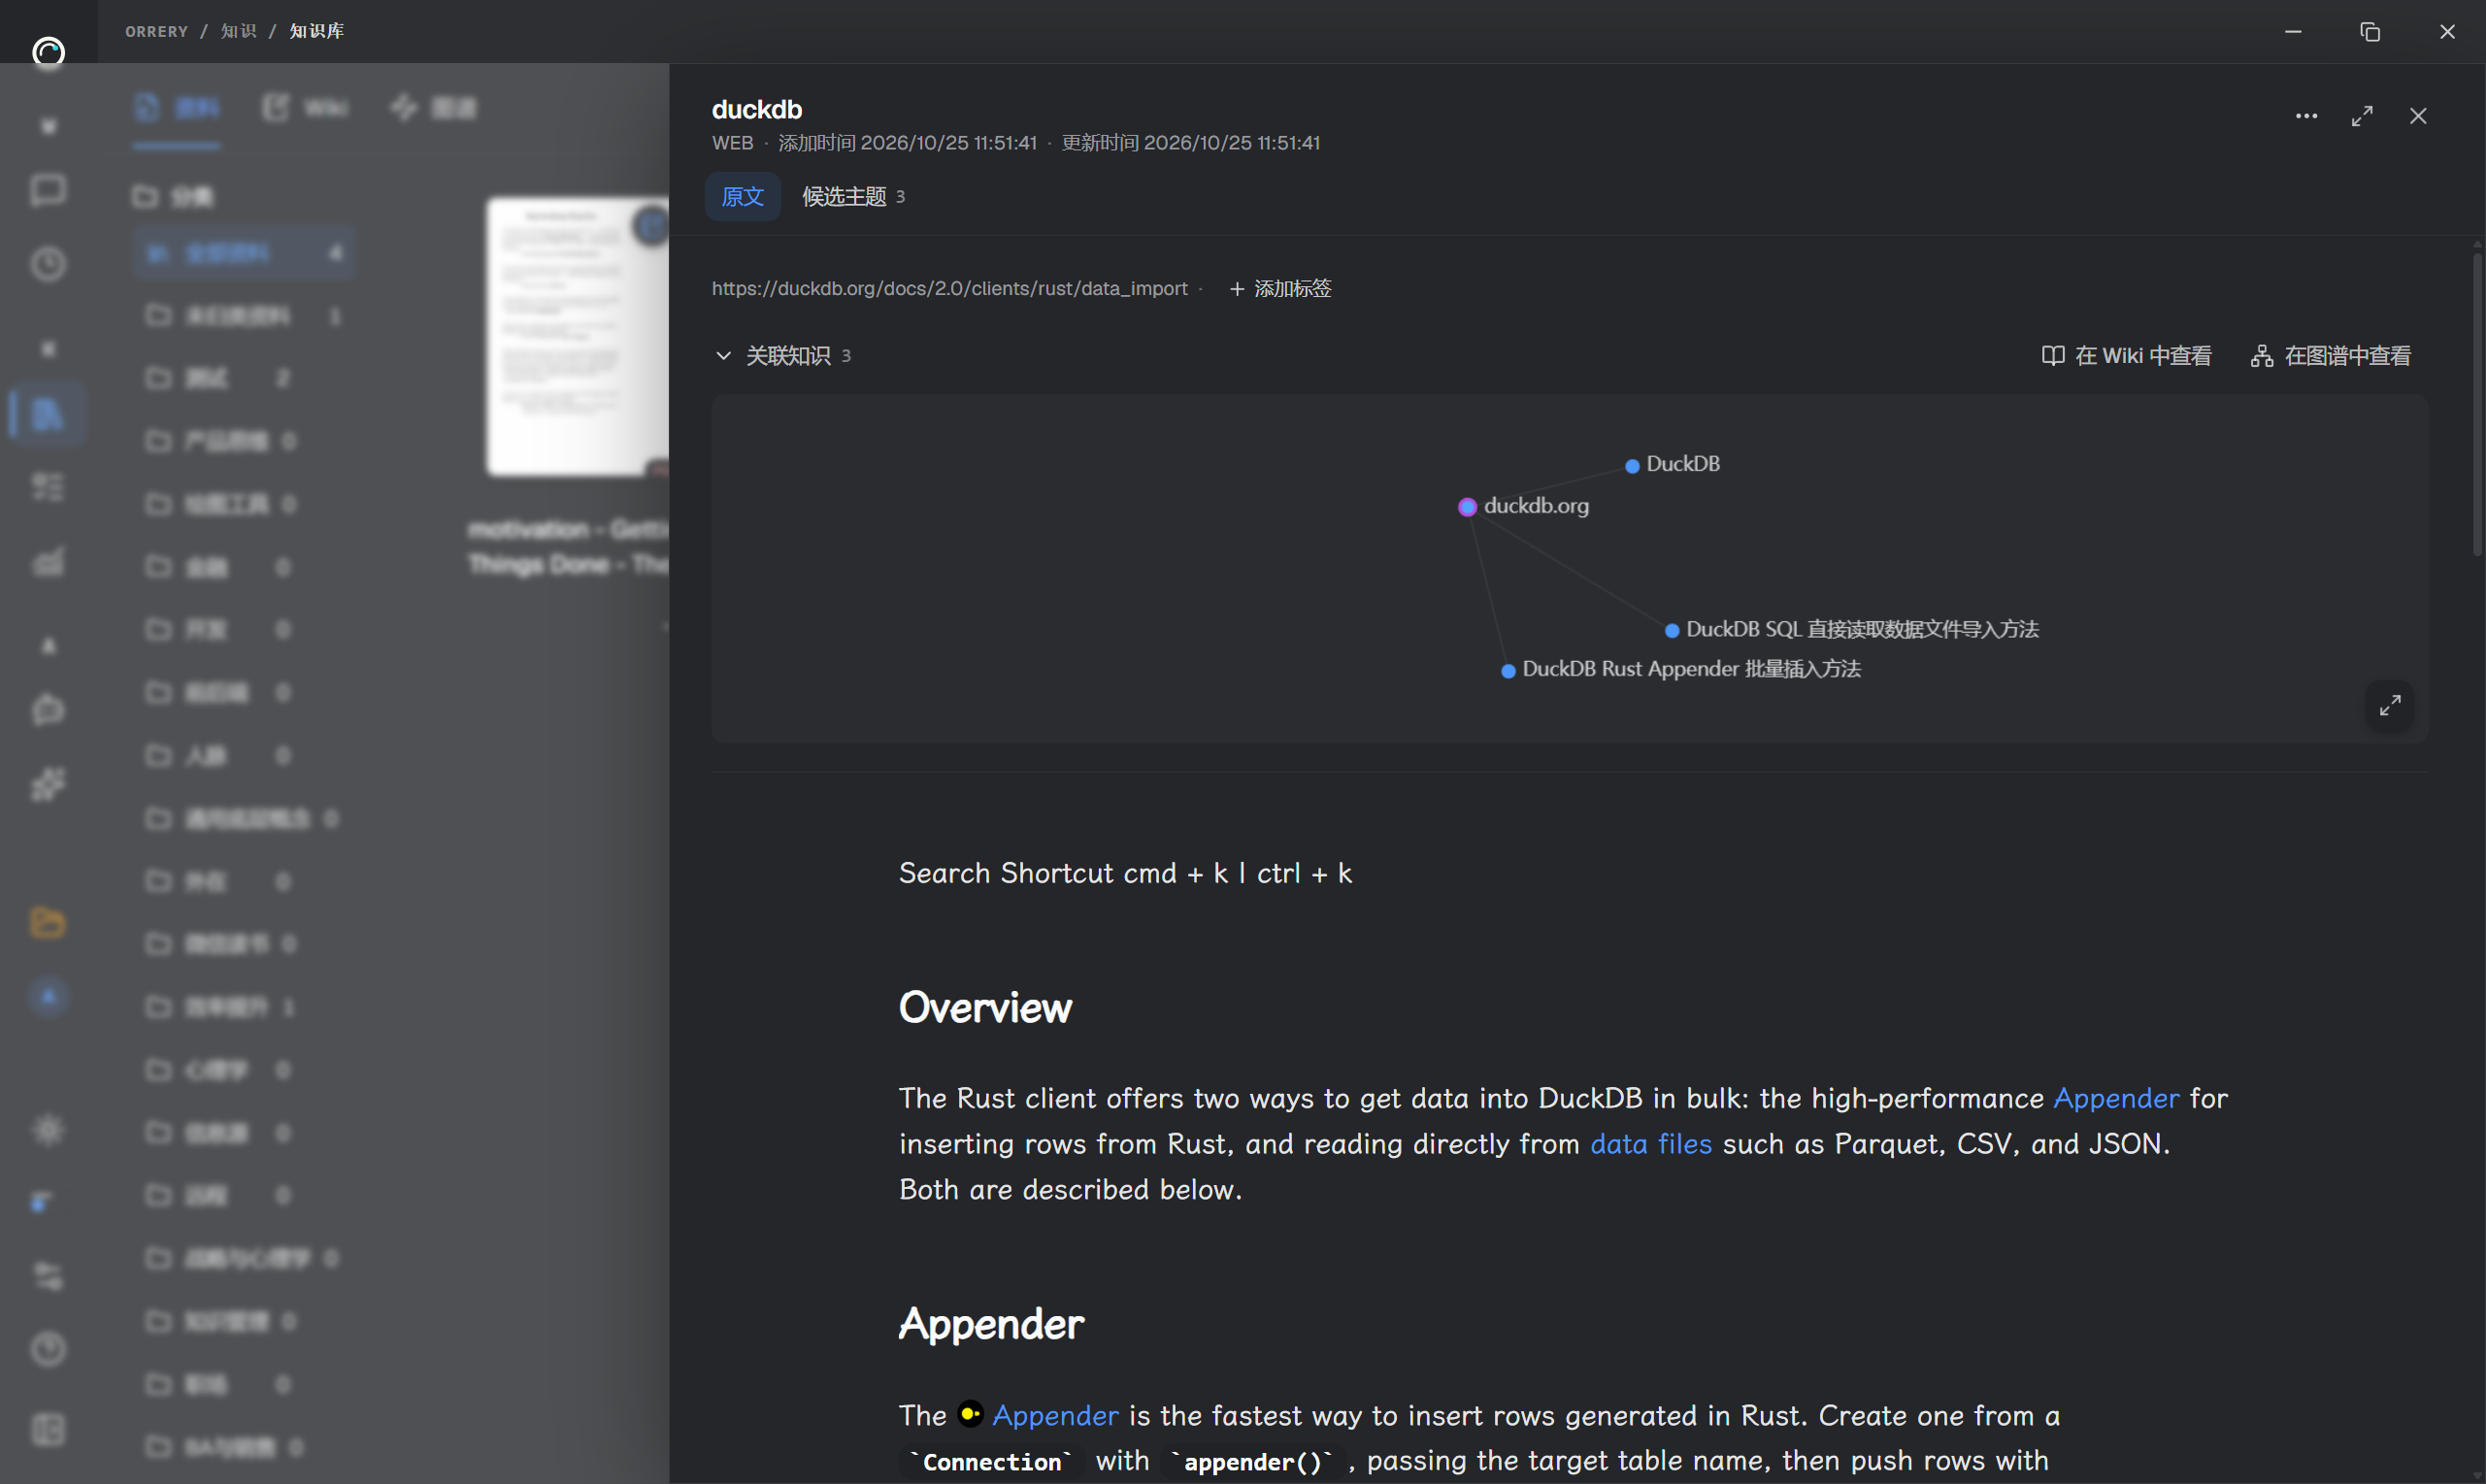
已保存的 DuckDB 网页与三个知识主题建立关联,可以继续到 Wiki 中查看。
管线更新 Wiki 根与知识域的 moc.md 导航,不等于更新所有 Project、Area、Resources 的 MOC 或项目 log.md。项目记录的维护见工作中的导航与日志。
Agent 怎样继续使用
你可以在对话中请 Agent 用 wiki_ingest 查找已登记资料、启动同一条处理管线并跟踪结果。人工主题确认仍在资料审核界面完成,详见资料摄取 Ingest|Agent 调用与人工确认。
生成的 Wiki 是可审核的长期知识,也能通过知识视野、MOC 导航、搜索和明确的文件引用参与后续工作。生成文件不会把全部正文自动塞进每次对话。继续阅读知识视野与知识的语义层。
Knowledge 与独立 Memory 的统一关联仍在研发。不要把一次 ingest 成功解释为“所有知识已经自动成为记忆”。
下一步:跟着处理一份资料。
目录和视觉选项以实际任务为准
示例中的 wiki/ 是资料库内的示意根,本机公开测试也使用这一路径。原生管线优先读取知识目录配置,没有配置时回退 wiki;其他前端处理代码还有不同的历史默认。不要为了匹配示意树手动迁移原件,以任务记录的实际输出路径为准。
不要把“不使用含凭据 URL”的操作建议理解为所有入口都已做了该校验。添加普通公开网页,避免把密码、Token 或私有访问参数放进资料地址。界面与 Agent 的图像默认项不同,见Agent 摄取选项。
文档核对说明
- 查看编写与验证范围
- 开发预览与截图范围
- 当前源码在开发模式开放资料处理,生产默认入口仍关闭。本页说明按当前代码核对。实拍来自 Windows 开发实例,完成记录使用已有公开 DuckDB 资料;本轮没有导入新资料、确认主题或重新生成 Wiki。
内容来自 Orrery Desktop 的 Wiki,文档仍在持续完善。功能开放情况以当前版本为准。