对话上下文|压缩、分叉与撤销
按目标选择上下文管理方式,并理解外部副作用的边界。
聊天历史变长后,保存的内容、屏幕上正在显示的内容和每次交给模型的上下文不完全相同。先判断遇到的是背景过多、方向分岔还是发错要求,再选择操作。
压缩用于保留要点、减少上下文
对话接近模型可处理的长度时,Orrery 会进行上下文预算处理;你也可以使用上下文相关入口手动压缩当前会话。
- 先确认正在操作的是哪场对话。
- 使用压缩入口;支持填写说明时,指出必须保留的目标、决定、文件路径与未完成项。
- 等待压缩结果。
- 继续时让 Agent 先复述当前目标,并核对必要的原始材料。
压缩会用摘要接续模型背景,不是把全部原话无损塞进更小空间。重要数据、完整引用或逐字要求应保存在文件中,后续需要时重新读取。
- 没有可压缩内容也可能出现
- 上下文占用高,不一定代表已有足够旧内容可以回收。新的大附件、工具说明或必须保留的近期材料,也会占用空间。持续超限时,缩小本轮输入,或新建对话并引用项目记录。
屏幕只显示一部分历史
长会话会按窗口读取历史,部分较早执行过程或长表格按需展开。这是阅读与性能安排,不能由“屏幕上暂时没有”推断历史已经被删除。
需要核对细节时,加载更早消息、展开相关过程或回到实际文件。不要把折叠后的短摘要当成完整原文。
压缩、Fork、新对话与撤销怎样选
- 继续同一目标,只是背景过长:压缩后接续。
- 保留共同背景,分别比较方案:从适合的回复处 Fork。
- 完全不同的工作:新建对话,按需引用材料。
- 某次要求发错,希望移除该处之后的聊天:确认范围后撤销发送。
Fork 不会隔离实际文件;撤销发送也不会回滚文件或外部操作。完整场景见分叉与撤销。
看懂上下文圆环
聊天输入区的上下文用量圆环可以展开。使用率和上下文 Token 帮助判断当前窗口压力;累计消费与缓存命中是不同指标,不把缓存命中率当作上下文剩余比例。
分段显示系统规则、工具、动态上下文、对话、记忆等内容的本地估算。分段占比按估算合计计算,总占用以供应商回传为准,两者不必完全相等;未知用量也不能当作零。这里可以进入压缩,但打开面板本身不会执行压缩。
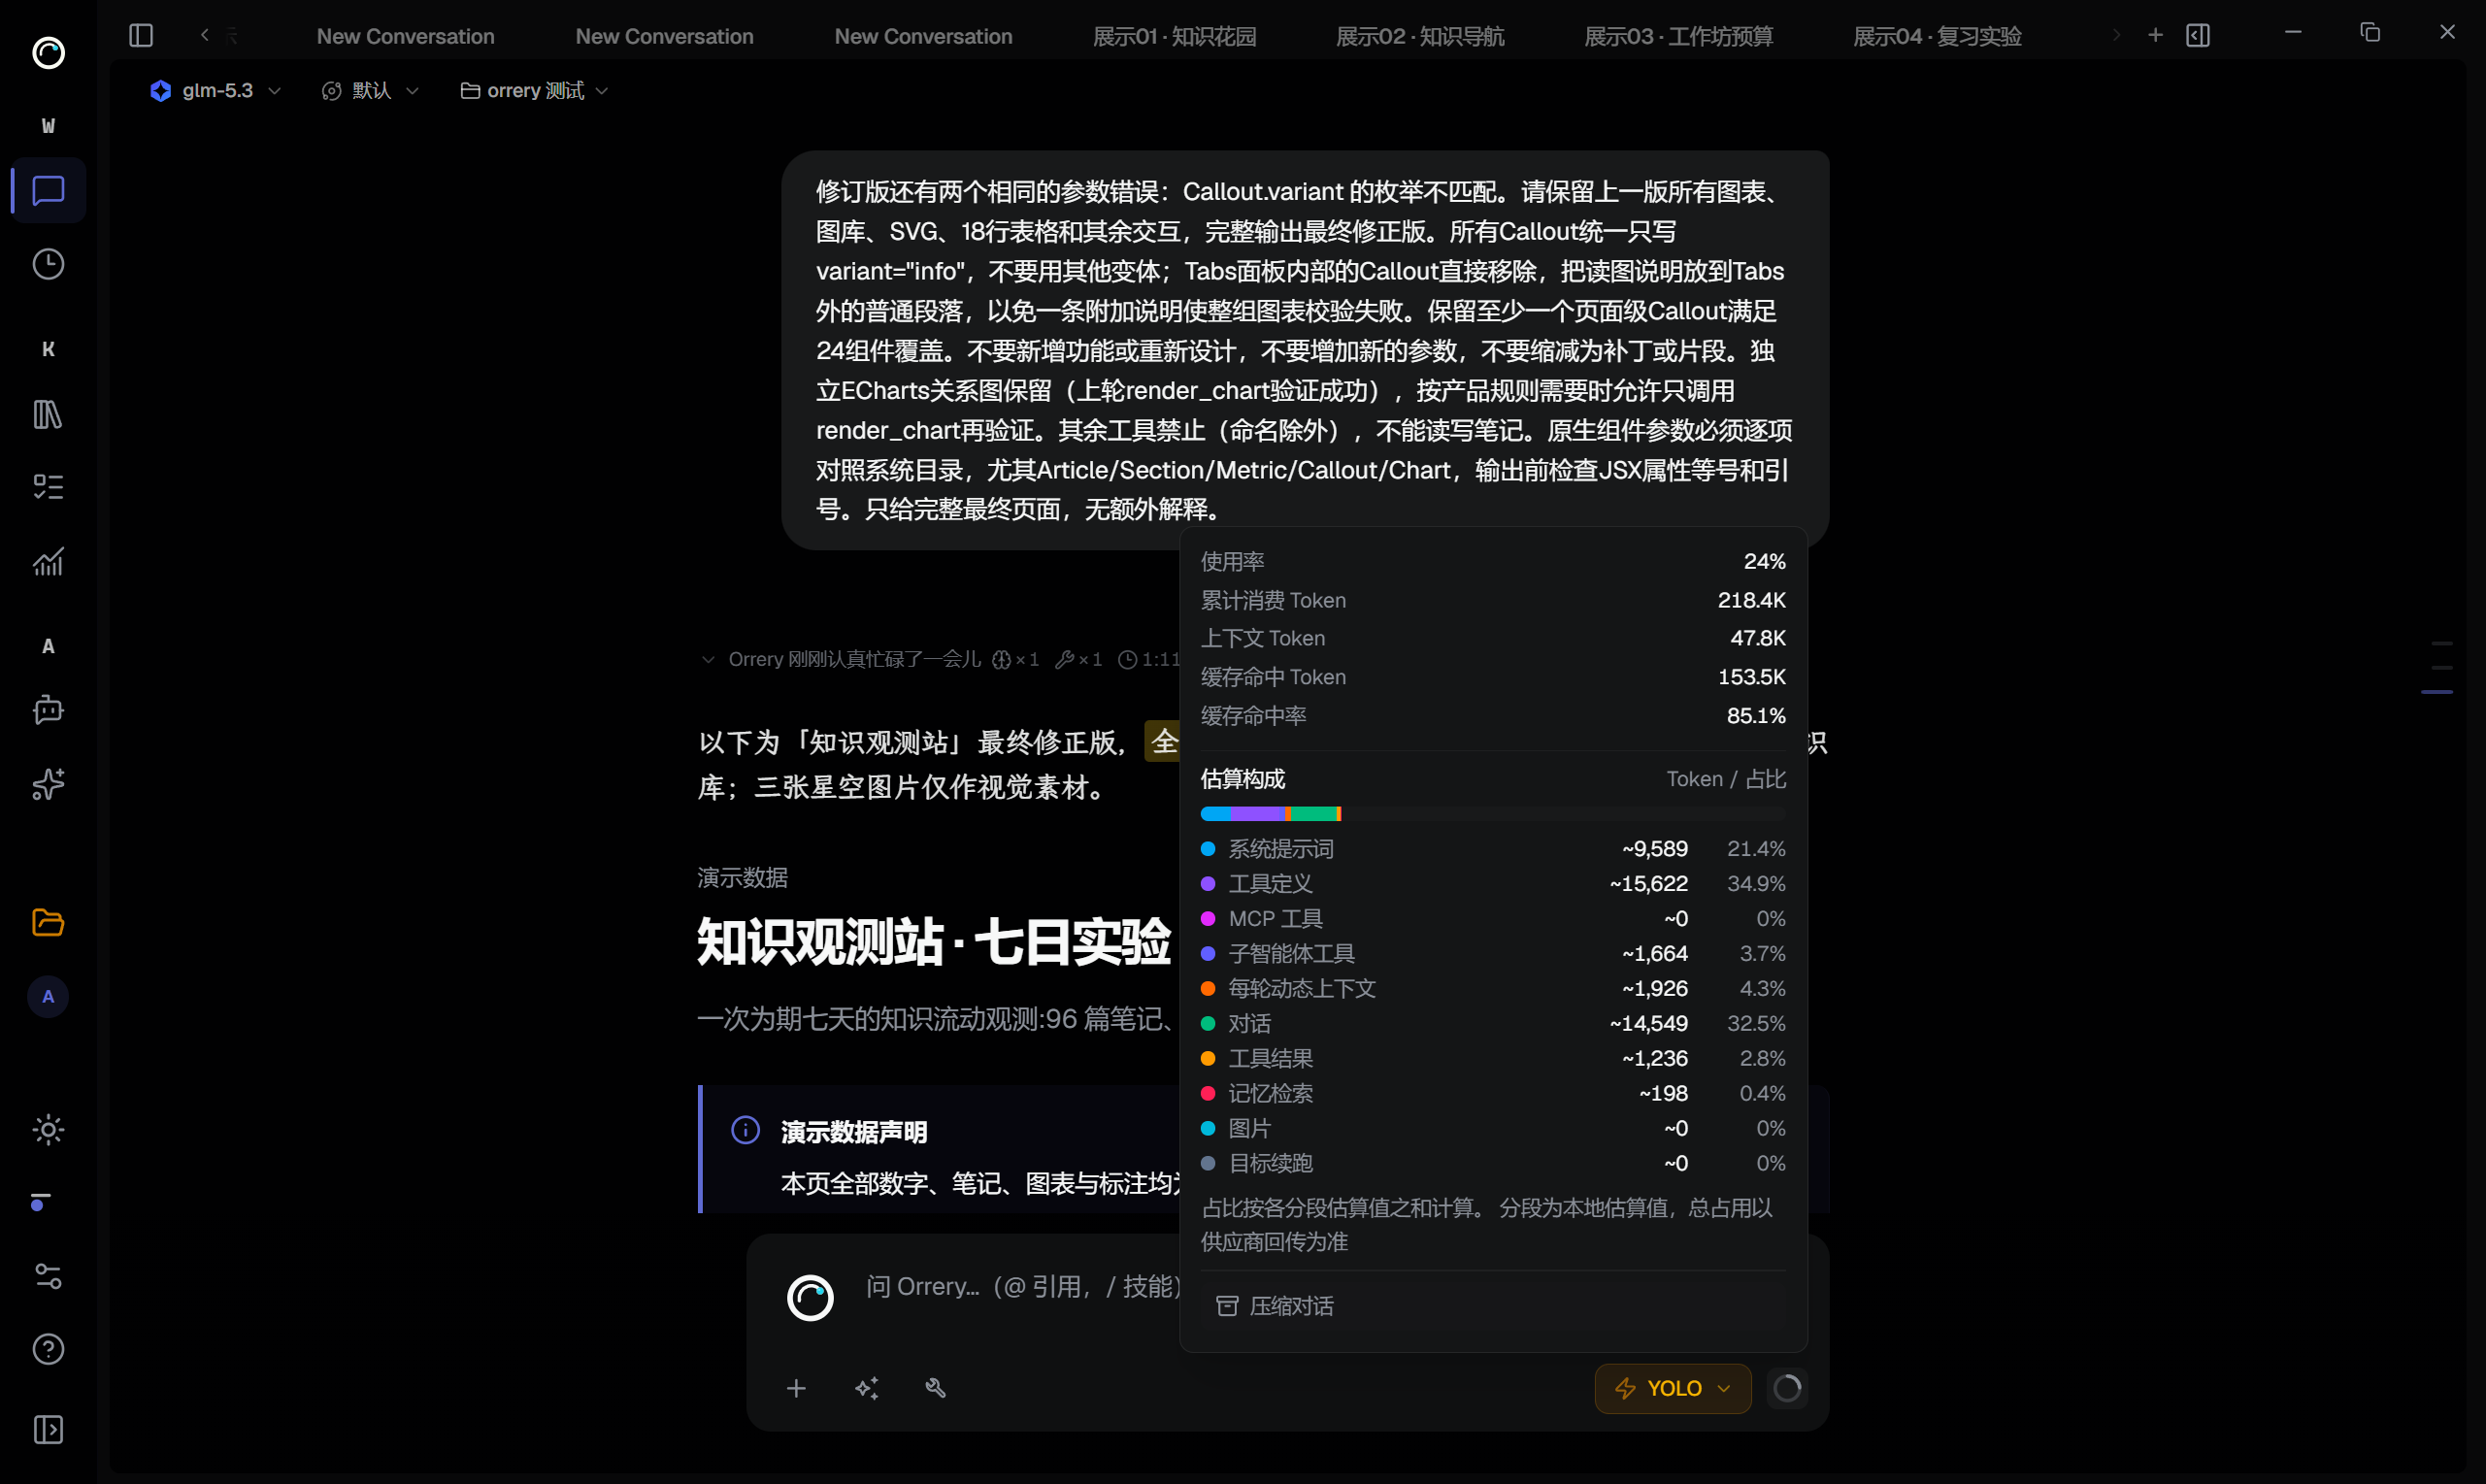
已有界面演示会话的圆环快照,用于说明位置、缓存与分段估算;不是本轮模型调用或压缩的验收记录。
压缩失败时
保留当前输入和错误信息,检查模型连接与上下文设置。等本次压缩明确结束后再重试,避免把多个压缩请求叠在一起。仍失败时,把目标、关键决定、原始材料路径和下一步整理到项目记录,再在较短的新对话中接续。
资料不应只存在于一场聊天里。收尾时更新 MOC 与 log.md,让下一次协作可以回到实际文件。
内容来自 Orrery Desktop 的 Wiki,文档仍在持续完善。功能开放情况以当前版本为准。